 우주개구리
계획과 구현에 서로 다른 모델을 쓰면 코드 품질을 유지하면서 토큰과 실행시간을 줄일 수 있는지 확인하려고 실험했다.
QuixBugs의 단일 함수 버그 6개를 Astra와 Luna로 수정했다. 계획과 구현을 다른 세션에 맡기는 방식, 한 세션에서 바로 구현하는 방식, Astra의 추론 강도를 비교했다.
가설
- 계획 세션을 분리하면 직접 구현보다 성공률이 높아지거나 전체 자원 소모가 줄어든다.
- Astra가 계획하고 Luna가 구현하면 역순보다 같은 성공률에서 토큰과 시간을 덜 사용한다.
- Astra의 추론 강도를 높이면 수정 성공률이 올라간다.
실험 설계
모델과 역할
- Astra:
gpt-6-astra.low,medium,high,xhigh,max,ultra를 각각 실행했다. - Luna:
gpt-5.6-luna. 계획과 구현 모두max로 고정했다.
두 글자 조건은 앞이 계획 담당, 뒤가 구현 담당이다. AL은 Astra 계획·Luna 구현, LA는 Luna 계획·Astra 구현을 뜻한다. AA와 LL은 같은 모델을 두 역할에 사용하며 AA는 추론 강도도 같게 맞췄다.
A와 L은 별도 계획 담당 없이 한 세션에서 분석·수정·공개 검증을 마친다. 세션 도중 모델이나 추론 강도를 바꾸지 않는다.
각 조건·추론 강도 조합에서 문제마다 한 번씩 실행했다. Astra가 포함된 AL·LA·AA·A는 각각 36조합, Luna만 사용하는 LL·L은 각각 6조합이다. LL·L을 Astra 강도별로 반복하지 않았다. 총 156조합, 최대 270세션이다.
실행 환경
macOS arm64에서 Codex CLI 0.153.4와 Python 3.14.7 하네스를 사용했다. 속도 설정은 Standard, 자동 재시도는 없었다.
계획 담당은 파일을 수정하지 않고 최소 수정 계획을 제출했다. 구현 담당에게는 계획 담당의 최종 응답만 전달하되 잘못된 계획은 고칠 수 있도록 했다.
모든 단계는 새 프로세스·작업 폴더·CODEX_HOME에서 시작했다. 메모리와 스킬, 웹 검색, 다른 에이전트 호출을 비활성화하고 작업 폴더의 접근 권한을 제한했다.
AL·LA·AA·LL은 계획과 구현에 각각 최대 180초를 배정해 한 문제에 총 360초까지 허용했다. 한 세션에서 처리하는 A·L은 분석·구현·공개 검증을 모두 합쳐 문제당 최대 180초로 제한했다.
시간은 CLI 프로세스 시작부터 종료까지 측정했다. 두 세션 조건은 계획과 구현 구간을 합산하고 사전 점검 시간은 제외했다. 캐시 입력과 추론 출력은 이미 각각 입력·출력에 포함되므로 다시 더하지 않았다.
문제와 판정
QuixBugs의 다음 Python 함수를 사용했다. 원본은 커밋 4257f44로 고정했다.
bitcount: 정수의 1비트 수find_first_in_sorted: 정렬된 배열에서 첫 일치 위치quicksort: 퀵 정렬next_palindrome: 다음 회문 수rpn_eval: 역폴란드 표기식 계산gcd: 최대공약수
공개 사례 18개와 모델에 제공하지 않은 추가 사례 424개를 사용했다. 기대값은 별도 생성기로 만들었다. 모든 제출을 고정한 뒤 추가 사례를 평가했으며 공개·추가 테스트를 통과하고 실행 규칙도 지켜야 PASS로 판정했다. QuixBugs 전체 표준 테스트를 사용한 결과는 아니다.
결과
유효한 155조합이 모두 테스트를 통과했다. 토큰과 실행시간이 가장 적었던 구성은 Astra low의 단일 세션 구현이었다.
AL의 xhigh / quicksort 한 건은 계획 세션이 약 4.48초 만에 중단되어 구현을 건너뛰었다. 완료 이벤트와 사용량이 없어 INVALID로 처리하고 오답 집계에서 제외했다.
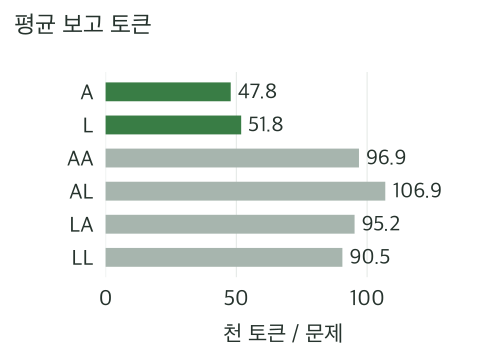
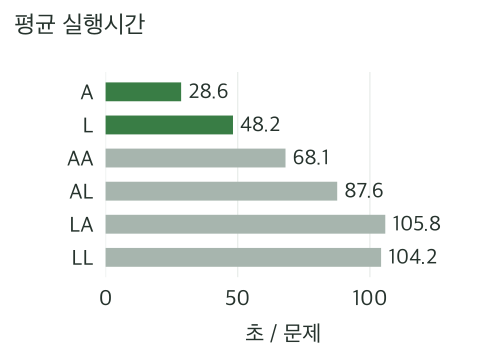
A low는 L max보다 합산 토큰이 7.7% 적었고 실행시간은 40.7% 짧았다. 6문제 모두 A low가 빨랐지만 토큰은 A low와 L max가 적게 쓴 문제가 각각 세 개였다.
계획 분리
모든 Astra 강도에서 같은 문제끼리 대응시키면 단일 A는 AA보다 토큰을 44.6%, 시간을 56.2% 덜 사용했다. 36쌍 모두 같은 방향이었다. 단일 L도 LL에 비해 토큰 42.7%, 시간 53.8%가 줄었고 6쌍 모두 통과했다.
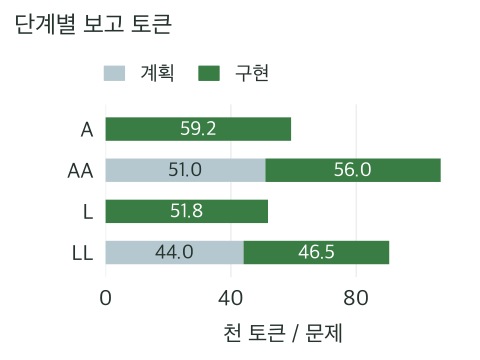
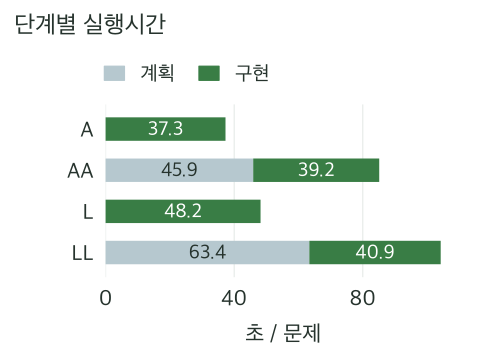
AA의 구현 단계는 단일 A보다 토큰을 평균 5.5%, LL의 구현 단계는 단일 L보다 10.3% 덜 썼다. 계획에 각각 평균 5.1만, 4.4만 토큰이 들어가면서 전체 사용량은 늘었다.
AL과 LA
중단된 조합을 양쪽에서 제외하고 35쌍을 비교했다. AL의 합산 실행시간은 LA보다 14.1% 짧았고 28쌍에서 AL이 빨랐다. 토큰 합계도 AL이 2.5% 적었지만 문제별로 나누면 18쌍에서 AL, 17쌍에서 LA가 적었다.
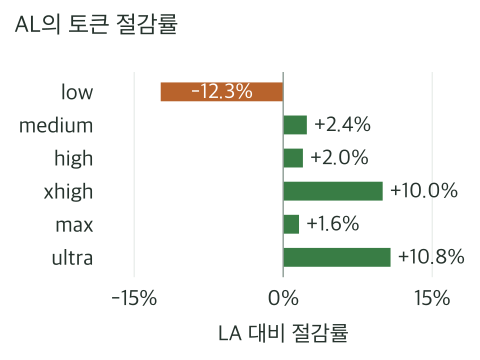
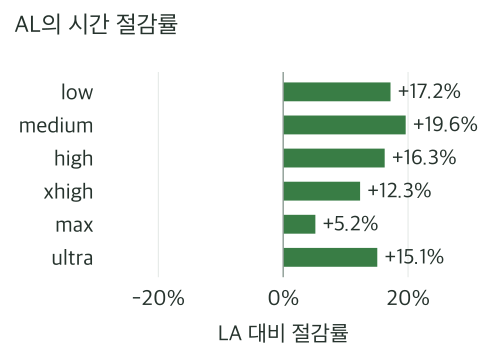
AL이 시간을 덜 쓰는 경향은 있었지만 토큰까지 일관되게 줄이지는 못했다. 테스트 성공률은 같았다.
추론 강도
단일 A는 low부터 ultra까지 모두 6/6을 통과했다.
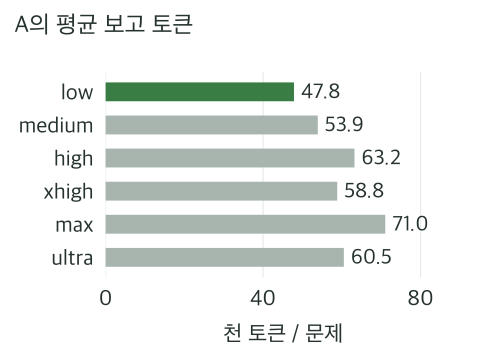
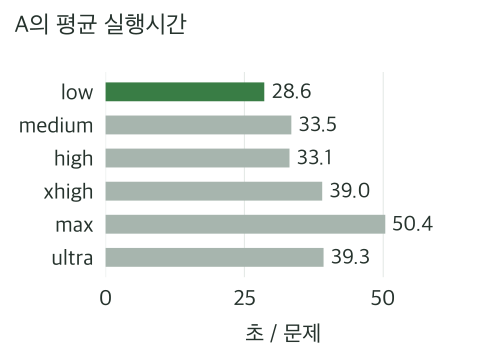
max는 low보다 토큰을 48.5% 더 쓰고 시간도 76.2% 더 걸렸지만 추가로 통과한 문제는 없었다. 토큰과 시간 모두 max가 ultra보다 컸다. 추론 강도를 높인 순서대로 사용량이 늘지는 않았으며 조건별로 한 번씩만 실행해 이런 차이가 난 원인은 알 수 없다.
구현 담당이 고친 계획 오류
구현 담당이 계획을 보완했다고 보고한 네 건은 모두 Luna의 계획이었다. 계획서와 수정 코드를 대조했을 때도 누락이나 오류가 있었다.
LA / low / bitcount의 계획은 코드가 올바르므로 수정하지 말라는 내용이었다. 원본의 갱신식은 n = 1에서도 값을 1로 남겨 루프를 끝내지 못한다.
n ^= n - 1구현 담당인 Astra는 XOR를 AND로 바꿨다.
n &= n - 1나머지 세 건은 find_first_in_sorted였다. LA medium·LA high·LL의 계획대로 상한 초기값만 줄여도 배열에 없는 값을 검색할 때 무한 반복이 남았다. 구현 담당이 상한 갱신까지 보완해 통과했다.
구현 담당이 잘못된 계획을 고칠 수 있어 계획 담당의 오류가 최종 성공률에 드러나지 않을 수 있다. PASS는 계획과 구현을 합친 결과이며 보완 보고가 없던 나머지 계획의 정확성은 독립적으로 판정하지 않았다.
해석 범위
서로 다른 문제는 6개이고 155개 통과 결과는 이 문제들을 여러 조건에서 반복한 결과다. 통과한 패치 중 147개는 한 줄 교체였고 나머지도 한두 줄 수준이었다. 공개 문제라 학습 데이터에 포함됐을 가능성도 있다.
추가 실험과 기존 실험의 실행 구간이 겹쳤다. 계정·서버·호스트에서 동시에 진행한 작업의 영향을 통제하지 못했고 Python 시작 과정의 xcrun 캐시 권한 경고도 238세션에서 관측됐다. 측정 시간에는 이런 도구 실행이 포함된다.
완료한 세션의 입력 토큰 중 79.7%는 캐시 입력이었다. 보고 토큰의 감소율을 청구 금액이나 구독 크레딧 감소율로 바꿀 수는 없다. 모델과 추론 강도는 로컬 호출 설정으로 확인했으며 백엔드 신원을 별도로 검증하지 않았다.
단순한 단일 함수 수정에서는 A low를 기본 후보로 둘 근거가 생겼다. 여러 파일의 의존성을 다루거나 긴 디버깅 과정을 거치고 새 요구사항을 설계하는 작업에도 같은 선택이 나을지는 아직 알 수 없다. 그런 작업에서 계획 분리와 추론 강도의 효과를 비교하려면 더 어려운 새 과제와 반복 실행이 필요하다.
댓글